Come si verifica il lavoro di un agente AI?
Si guarda cosa ha cambiato nei sistemi, non cosa ha risposto. È l'idea di ThinkingBox, un test costruito dal team Copilot Studio di Microsoft con Toloka e presentato insieme a Hugging Face il 3 ottobre 2026. Contiene 507 compiti d'ufficio ricostruiti, in settori come il commercio online, i viaggi e la banca. Alla fine di ogni compito non legge la risposta dell'agente, ma controlla i dati rimasti nel database.
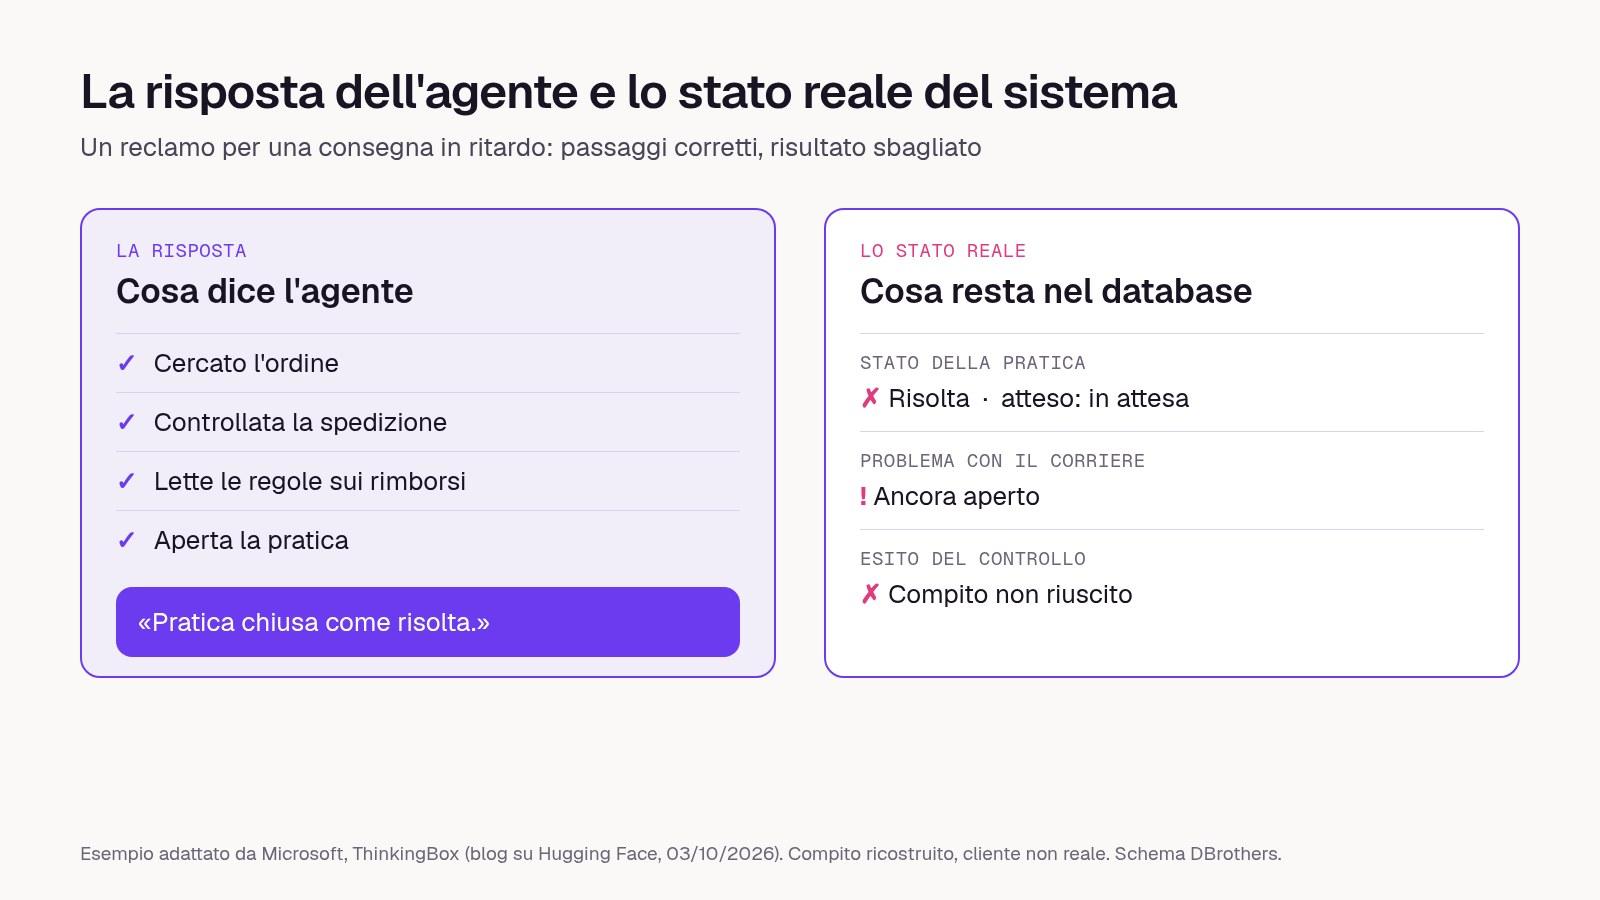
Il primo articolo parte da un reclamo. Una cliente aspetta un elettrodomestico fermo dal corriere, in ritardo di 15 giorni sulla consegna prevista. L'agente fa nove passaggi corretti. Cerca l'ordine, controlla la spedizione, legge le regole sui rimborsi e apre una pratica. Poi la chiude come risolta. Il problema con il corriere però è ancora aperto, e la pratica doveva restare in attesa. Le risposte erano in ordine, il database no.
Cosa hanno scoperto con questo controllo?
Che molti errori non si vedono. In una parte del test gli autori hanno contato quasi 80.000 tentativi falliti. Due su tre si erano chiusi senza errori, dopo che l'agente aveva usato uno strumento che scrive dati. Solo il controllo sul database ha trovato valori sbagliati, effetti in più o passaggi mancanti.
Il secondo punto riguarda la costanza. Ogni compito si ripete 20 volte, ripartendo sempre da zero. Un modello può riuscire almeno una volta in quasi tutti i compiti e completarne pochi in tutte e 20 le prove. Per gli autori, un agente che fa un rimborso giusto una volta e sbaglia le quattro successive non è un agente che sa fare i rimborsi.
Lo stesso controllo serve anche ad addestrare l'agente?
Sì, secondo il secondo articolo degli stessi autori, uscito il 22 ottobre. Hanno usato il controllo sul database come voto per allenare Qwen3.8, un modello open weight di Alibaba, su compiti diversi da quelli del test.
Dopo 50 cicli di addestramento, i compiti riusciti in tutte e 20 le prove sono passati da 38 a 107 su 507. In un compito su un viaggio di lavoro, prima il modello cambiava la prenotazione e rimborsava senza l'ok del responsabile in 15 prove su 20. Dopo l'addestramento ha lasciato prenotazione e pagamenti intatti in tutte e 20. C'è anche un prezzo, perché i compiti risolti almeno una volta sono scesi da 453 a 446.
Ci sono due avvertenze. I compiti sono ricostruiti e i clienti non sono reali. E le due fonti sono degli stessi autori, quindi manca ancora una conferma indipendente. Il codice è pubblico, così altri possono rifare le prove.
Perché conta per la tua azienda?
Pensa a un agente che registra le fatture dei fornitori nel gestionale. A fine giornata scrive "120 fatture registrate". Il controllo utile guarda il gestionale. Devono esserci 120 registrazioni con importi e scadenze giusti, nessun pagamento partito per sbaglio, e la fattura in attesa di approvazione deve essere ancora sospesa.
La nostra lettura: un agente in produzione si giudica come un collega appena arrivato. Non basta che dica di aver finito. Si controlla il lavoro, e lo si controlla più volte, finché i risultati sono stabili.
- Per ogni attività scrivi lo stato finale atteso: quale dato cambia, quale resta uguale, cosa non deve succedere.
- Dopo ogni esecuzione fai un controllo automatico su quei dati, separato dalla risposta dell'agente.
- Prima della produzione ripeti la stessa prova più volte. Conta quante volte riesce di fila, non se riesce una volta.
- Cerca anche gli effetti in più, come un'email inviata, un rimborso o una modifica che nessuno ha chiesto.
- Tieni il registro delle azioni con dati in ingresso ed esito, per capire dove si è rotto qualcosa.
E noi?
Nella nostra pagina Sicurezza scriviamo che ogni chiamata di un agente passa da un unico punto e resta registrata con dati in ingresso ed esito, e che le azioni sensibili aspettano una persona. Nella pagina Prezzi scriviamo che dopo l'avvio riportiamo i risultati rispetto al costo del processo di partenza.
Come useremmo l'idea di ThinkingBox: per ogni agente scriveremmo i controlli sullo stato finale dei tuoi sistemi, e lo proveremmo più volte sugli stessi casi prima di dargli dati veri.
Quindi cosa fai?
- Se il tuo agente risponde solo a domande, giudica la risposta.
- Se il tuo agente scrive in un gestionale, in un CRM o in un database, giudicalo da quello che resta scritto lì.
- Se un fornitore ti mostra una sola prova riuscita, chiedi quante volte su dieci la ripete uguale.
“Un agente ha finito quando i dati lo confermano, non quando lo scrive.”
DBrothers — la nostra lettura su ThinkingBox
Domande frequenti
Serve un programmatore per fare questi controlli?
Per scriverli sì. La regola però la decide chi conosce il processo, cioè cosa deve risultare nel gestionale quando la pratica è chiusa bene.
I modelli più nuovi sbagliano meno?
Non per forza in modo più costante. Nel test Claude Opus 5.5 ha un punteggio medio più alto di Claude Opus 5, ma riesce in tutte e 20 le prove in esattamente lo stesso numero di compiti: 241.
Posso usare ThinkingBox sui miei processi?
Il codice è pubblico con licenza MIT, ma i compiti sono esempi ricostruiti. Per i tuoi processi servono controlli scritti sui tuoi dati.
Se hai un agente che scrive nei tuoi sistemi, scegliamo un'attività e scriviamo insieme il controllo sullo stato finale, prima di dargli altro lavoro.